Nếu AI Agent đang chạy 5 bước, vì sao người dùng chỉ thấy một dòng “Đang xử lý”?
Nếu AI Agent đang chạy 5 bước, vì sao người dùng chỉ thấy một dòng “Đang xử lý”? Agent có thể gọi tool, lập kế hoạch và cập nhật trạng thái. Nhưng nếu giao diện không nhận được những tín hiệu đó, trải nghiệm vẫn chỉ là một ô chat im lặng. AG-UI là gì? AG-UI có thể hiểu là một giao thức mở, nhẹ và dựa trên sự kiện, giúp agent backend trao đổi với ứng dụng hướng người dùng. Frontend nhận được tín hiệu để hiển thị đúng tiến trình. AG-UI không phải bộ UI component, cũng không có nghĩa là AI được tự do “vẽ mọi thứ”. Trong một luồng làm việc, UI có thể nhận các tín hiệu như: 🔧 Tool lifecycle: tool bắt đầu, đang stream, hoàn tất hoặc thất bại. 📍 Progress và state: agent đang ở bước nào, đang chờ dữ liệu gì. 🧩 Structured input: người dùng cần chọn phạm vi, điền form hoặc xác nhận hành động. 📊 Partial result: kết quả được gửi từng phần thay vì phải chờ câu trả lời cuối. Ví dụ, một agent tra cứu tài liệu có thể hiển thị: Đang tìm kiếm → Chọn phạm vi → Bảng kết quả → Giải thích lỗi nếu tool thất bại Người dùng không phải đoán chuyện gì đang xảy ra. Developer cũng dễ thiết kế validation, fallback và trạng thái lỗi hơn. Mức tự do nào là phù hợp? Static cho phép frontend kiểm soát cao, agent chọn các component có sẵn. Declarative cho phép agent trả về UI spec có cấu trúc. Cách này linh hoạt hơn nhưng vẫn có ranh giới. Open-ended cho agent nhiều tự do hơn, đồng thời đòi hỏi kiểm soát chặt về security, performance và consistency. Vì vậy, đừng gộp cả ba thành câu “AI tự thiết kế giao diện”. Bài toán thực tế là cân bằng freedom và control. Khi xây một agent, hãy thiết kế UI contract song song với tool contract: • Event nào được phát? • State nào cần hiển thị? • Input nào phải validate? • Nếu tool fail, người dùng sẽ thấy gì và làm bước nào tiếp theo? Agent càng hành động nhiều, giao diện càng cần minh bạch. Chat là cửa sổ; event và state là đường ống giúp người dùng quan sát con tàu đang chạy. Bạn muốn Agent hiển thị tiến trình dưới dạng timeline, card hay bảng điều khiển? Chia sẻ use case bạn đang xây ở phần bình luận và theo dõi Suijin Greenverses để cùng giải mã những lớp công nghệ phía sau AI Agent. 🌌 #SuijinGreenverse #AIAgent #GenerativeUI #AGUI #DeveloperTools
Agent xử lý xong một issue trong benchmark. Nhưng nếu không thể replay lần chạy
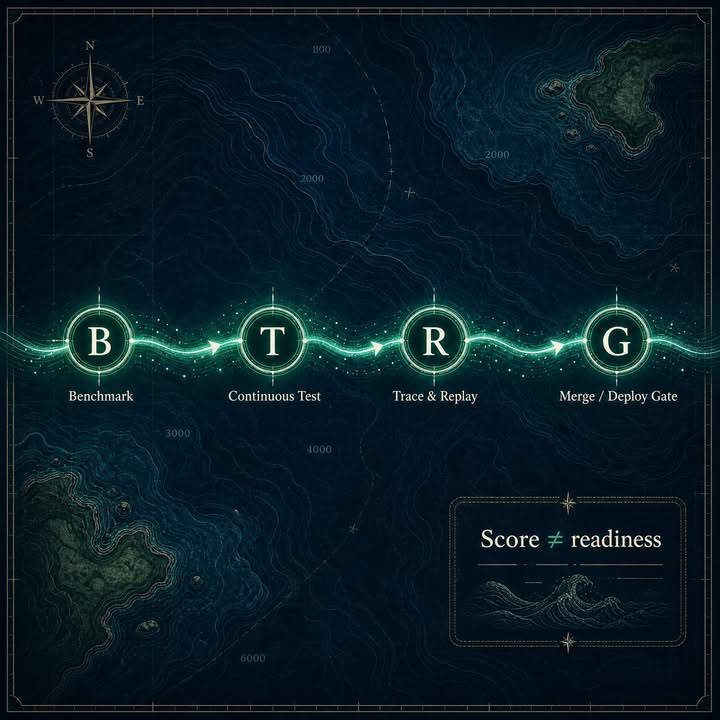
Agent xử lý xong một issue trong benchmark. Nhưng nếu không thể replay lần chạy đó, bạn đang merge một patch hay chỉ đang cược vào may rủi? Một kết quả benchmark tốt cho thấy agent xử lý được một nhóm task trong một setup cụ thể. Nó chưa trả lời câu hỏi quan trọng hơn: khi chạm vào codebase thật, team có biết agent đã làm gì, vì sao nó sai và chặn nó ở đâu không? Có thể nhìn một AI coding agent qua 4 lớp B/T/R/G: – B, Benchmark: agent có giải được task mẫu với tiêu chí rõ ràng không? – T, Continuous Test: khi codebase hoặc dependency thay đổi, kết quả còn ổn định không? – R, Trace & Replay: có lưu tool call, trạng thái và log để tái hiện lần chạy không? – G, Merge/Deploy Gate: patch có qua test, review, policy và workspace cô lập trước khi merge hoặc deploy không? OpenHands SDK dùng event làm nền cho trạng thái hội thoại và hỗ trợ replay. AgentLab là framework để phát triển và đánh giá web agent qua benchmark, thí nghiệm quy mô lớn và các tính năng reproducibility. Hai ví dụ này gợi ra một cách làm thực tế: xây vòng đánh giá quanh agent, thay vì chỉ nhìn một con số trên leaderboard. SWE-bench Verified là một bộ đánh giá tĩnh. Khác biệt về release và setup có thể khiến kết quả khó so sánh. Vì vậy, benchmark pass chỉ nên là tín hiệu đầu vào. Quyền merge vẫn cần thuộc về quy trình kiểm thử, truy vết và review của team. Câu hỏi đáng hỏi không chỉ là “agent đạt bao nhiêu điểm?”. Mà là: “Nếu agent sai, tôi có tái hiện được, giải thích được và chặn được lần chạy đó không?” Trong quy trình của bạn, lớp nào còn thiếu: B, T, R hay G? Comment một chữ và nói ngắn lý do. Nếu thấy hữu ích, hãy lưu bài viết để dùng khi review AI coding agent và chia sẻ cho người đang cân nhắc merge patch do agent tạo. #SuijinGreenverse #AIAgent #DevTools #SoftwareEngineering Nguồn tham khảo: https://github.com/OpenHands/software-agent-sdk https://github.com/ServiceNow/AgentLab/blob/main/README.md https://openai.com/index/introducing-swe-bench-verified/ https://www.swebench.com/verified.html
Một AI Agent có thể rất thông minh nhưng vẫn chật vật khi bước vào production.
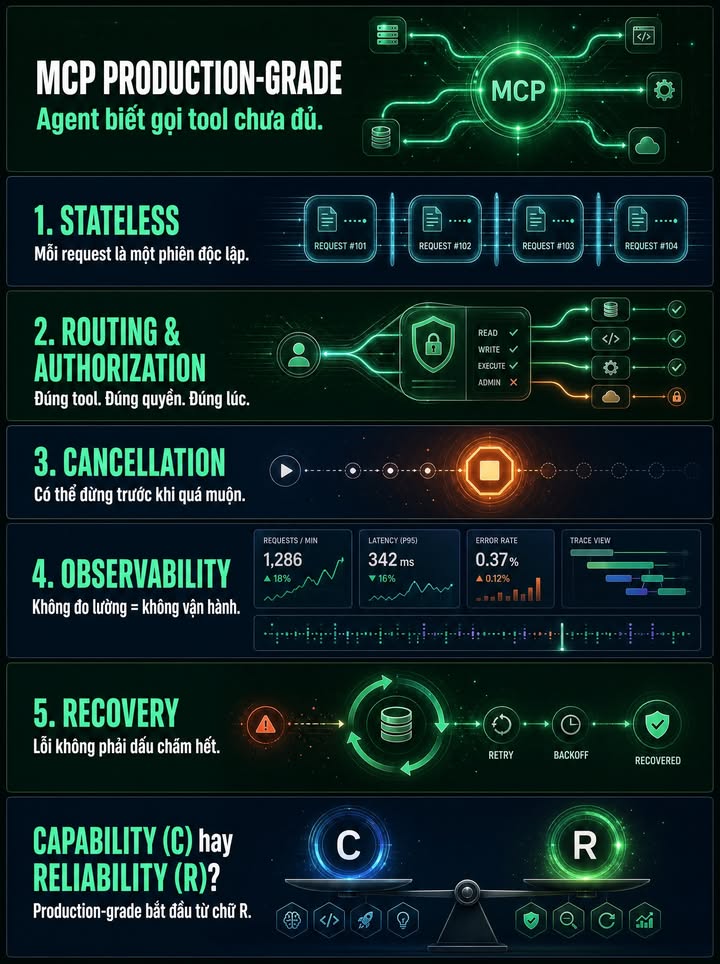
Một AI Agent có thể rất thông minh nhưng vẫn chật vật khi bước vào production. MCP 2026-07-28 đưa lớp kết nối của Agent gần hơn với cách hạ tầng web hiện đại vận hành: request tự mô tả, ít phụ thuộc vào session và dễ phân phối qua nhiều instance. Điểm đáng chú ý: Stateless protocol core: mỗi request mang theo thông tin cần thiết, giúp hệ thống dễ scale ngang hơn qua load balancer. Điều này không có nghĩa ứng dụng không được giữ state; state nghiệp vụ vẫn cần được quản lý ở tầng ứng dụng. Header-based routing: Mcp-Method và Mcp-Name cho phép gateway, rate limiter hoặc WAF route và kiểm soát request từ header, thay vì phải đọc body JSON. MRTR: Multi Round-Trip Requests xử lý những tình huống tool cần thêm thông tin hoặc xác nhận giữa chừng mà không phải giữ một kết nối hai chiều mở liên tục. Cache hints: các phản hồi list có thông tin như ttlMs và cacheScope, giúp client cân nhắc cách cache catalog tool, prompt và resource. Nhưng MCP không tự động biến một hệ thống thành production-grade. Đội ngũ vẫn phải kiểm thử tương thích, thiết kế quyền tối thiểu, theo dõi request, xử lý hủy tác vụ và chuẩn bị recovery khi tool hoặc upstream gặp lỗi. Với tác vụ dài, hãy xem xét cơ chế Tasks; với state nghiệp vụ, hãy truyền một handle rõ ràng ở tầng ứng dụng. Khi Agent gọi CRM, kho đơn và hệ thống hoàn tiền, câu hỏi không chỉ là “model thông minh đến đâu?” mà còn là “hệ thống có route đúng, cấp đúng quyền và phục hồi được khi có sự cố không?” Nếu phải ưu tiên một tiêu chí cho Agent production, bạn chọn Capability hay Reliability? Comment “C” hoặc “R” và nói rõ lý do. Lưu bài để dùng làm checklist trước khi scale. #AIAgent #MCP #AIInfrastructure #AgentEngineering #SuijinGreenverses
Bạn gọi đó là “AI tự chủ” — nhưng ai đang giữ nút STOP?
Bạn gọi đó là “AI tự chủ” — nhưng ai đang giữ nút STOP? Một agent không chỉ tự chủ vì model thông minh hơn. Mức tự chủ còn được quyết định bởi chiến lược giám sát của con người và cách sản phẩm trao quyền cho nó. 🌊 Hãy tách 3 khái niệm thường bị trộn lẫn: • Capability — model có thể làm được gì?• Autonomy — agent có thể tự đi qua bao nhiêu bước trước khi cần người can thiệp?• Permission — agent thực sự được phép làm gì trong hệ thống? Ba lớp này không đồng nghĩa. Một model có thể lập kế hoạch rất tốt, nhưng vẫn nên chạy trong phạm vi quyền hạn hẹp. Ngược lại, một agent “ít thông minh hơn” nhưng được cấp quyền rộng, auto-approve nhiều và thiếu cơ chế hoàn tác có thể tạo ra rủi ro lớn hơn. 📌 Nghiên cứu của Anthropic trên hàng triệu tương tác cho thấy: • Session Code dài nhất tăng từ dưới 25 lên trên 45 phút trong 3 tháng.• Tỷ lệ full auto-approve khoảng 20% ở người dùng mới và trên 40% ở nhóm nhiều kinh nghiệm.• Gần 50% hoạt động agentic trên public API gắn với software engineering. Những con số này không nói rằng “AI đã tự chủ hoàn toàn”. Chúng cho thấy một điều thực tế hơn: con người đang dần thiết kế những vòng lặp dài hơn và trao cho agent nhiều quyền hơn — tùy theo mức độ tin tưởng, khả năng giám sát và độ dễ hoàn tác của công việc. ⚓ Vì vậy, khi đưa agent vào production, câu hỏi quan trọng không phải là: “Model này thông minh đến đâu?” Mà là: 1. Agent được phép truy cập dữ liệu và công cụ nào?2. Hành động nào cần người xác nhận?3. Nếu làm sai, có rollback được không?4. Ai có quyền ngắt quy trình?5. Ta đang đo autonomy bằng dữ liệu nào — và dữ liệu đó có đại diện cho mọi ngành không? 🧭 Nói thật: nghiên cứu trên tập trung vào Claude Code/public API và các tác vụ liên quan đến coding. “Autonomy” ở đây là một khái niệm vận hành, không phải benchmark năng lực chung cho mọi model hay mọi loại agent. Không nên lấy các tỷ lệ trên để suy ra rằng agent trong doanh nghiệp nào cũng sẽ đạt cùng mức tự chủ. Cách đi an toàn hơn là bắt đầu từ vùng nước nông: • Quyền hạn tối thiểu• Hành động có thể đảo ngược• Logging và evaluation rõ ràng• Human escalation ở các điểm rủi ro cao• Mở rộng autonomy chỉ sau khi có bằng chứng vận hành Agent giỏi là lợi thế. Agent được trao đúng quyền mới là hệ thống có thể sống sót ngoài biển lớn. Agent của bạn hiện đang được phép làm gì mà chưa có cơ chế rollback? Chia sẻ một quyền hạn bạn sẽ giữ lại ở chế độ “cần người duyệt” — và vì sao. #AIAgent #AgenticAI #AIGovernance #Automation #SuijinGreenverse Nguồn gốc: https://www.facebook.com/122110280187349377/posts/122132395041349377
AI đang rời khỏi ô chat. Nó bắt đầu nhận việc.
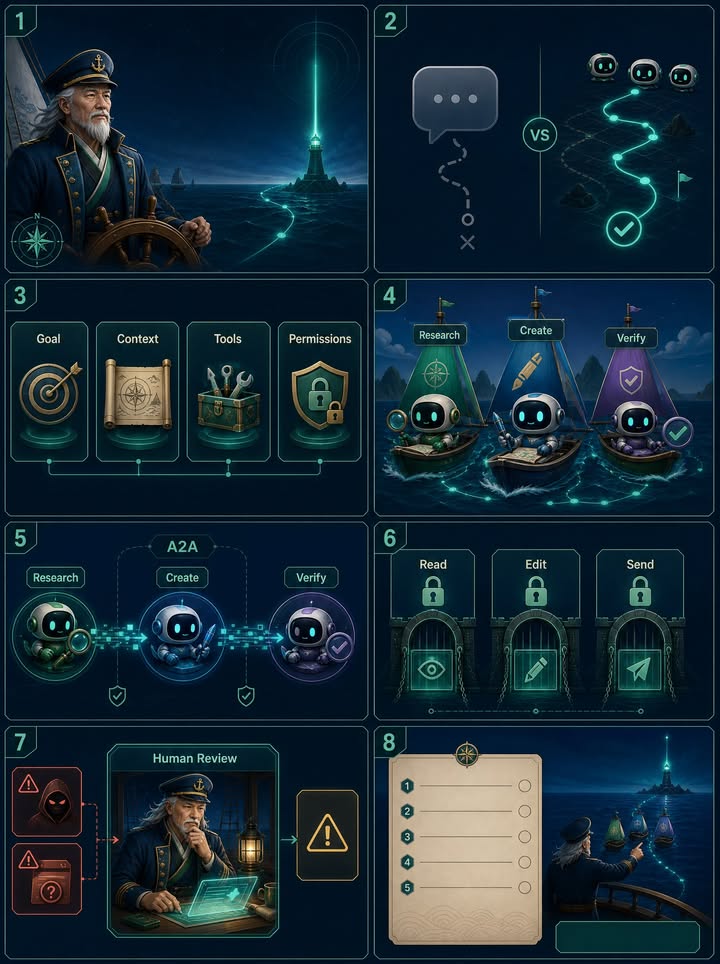
AI đang rời khỏi ô chat. Nó bắt đầu nhận việc. Ngày trước, ta giao cho chatbot một câu hỏi. Bây giờ, ta có thể giao cho một agent cả một nhiệm vụ: “Đọc 10 nguồn đáng tin, so sánh các phương án, viết bản tóm tắt và đánh dấu chỗ cần tôi duyệt.” Chatbot thường tạo một câu trả lời trong một lượt. Agent có thể xử lý nhiều bước trong giới hạn được cấp: nhận mục tiêu, tìm dữ liệu, dùng công cụ, phối hợp với agent khác rồi gửi kết quả để con người kiểm tra. Một agent muốn làm việc tử tế cần 4 mảnh ghép: 🎯 Mục tiêu: Kết quả cuối là gì? Bản nghiên cứu, báo cáo, email hay một quyết định có điều kiện? 🧭 Context và dữ liệu: Agent được đọc nguồn nào, phiên bản nào, dữ liệu nào là nội bộ? Không có context đúng, agent chỉ đang đoán có vẻ tự tin. 🛠️ Công cụ: Tìm kiếm, đọc file, gọi API, cập nhật bảng, tạo bản nháp. Công cụ giúp agent chuyển từ biết sang làm. 🔐 Quyền hạn và vòng kiểm tra: Agent được phép xem gì, sửa gì, gửi gì? Những hành động có thể gây hậu quả cần permission gate và human review, nhất là trước khi gửi ra ngoài, xóa dữ liệu hoặc chi tiền. Hãy hình dung một đội nhỏ trên hạm đội tri thức: 🔎 Research tìm và đối chiếu nguồn. ✍️ Create biến kết quả thành bản nháp. ✅ Verify kiểm tra dẫn chứng, lỗi và điều kiện an toàn. Ba agent có thể bàn giao việc cho nhau. A2A, viết tắt của Agent-to-Agent, là giao thức giúp các agent phối hợp. Trong một số cách triển khai, agent chuyên môn có thể giữ dữ liệu và quy trình trong ranh giới riêng, rồi trả về cho agent yêu cầu phần kết quả cần thiết. Cách vận hành cụ thể vẫn phụ thuộc vào thiết kế hệ thống và quyền truy cập. Một vài tín hiệu cho thấy agent đang được đưa vào công việc thực tế: • OpenAI báo cáo Codex tạo 64% tổng output token kết hợp giữa Codex và ChatGPT ở khách hàng doanh nghiệp. Nhóm doanh nghiệp dùng AI ở mức cao tạo 8,3 lần output token trên mỗi người dùng hoạt động so với nhóm điển hình. Đây là chỉ báo về độ sâu sử dụng, không phải cam kết năng suất hay ROI. • Trang giới thiệu báo cáo “2026 State of AI Agents” của Anthropic nêu 80% tổ chức được khảo sát báo ROI đo được; mẫu gồm hơn 500 lãnh đạo kỹ thuật. Đây là số liệu theo báo cáo của Anthropic, cần đọc cùng phương pháp khảo sát và bối cảnh triển khai. • Google mô tả A2A qua các tình huống agent chuyên môn nhận việc, làm việc trong môi trường riêng và trả kết quả cho agent yêu cầu. Càng được giao việc, agent càng cần hàng rào: ⚠️ Least privilege: chỉ cấp đúng quyền cần cho nhiệm vụ. ⚠️ Prompt injection: dữ liệu được đọc có thể chứa chỉ dẫn độc hại. ⚠️ Nguồn sai: agent có thể tổng hợp một điều không đúng từ những nguồn trông rất hợp lý. ⚠️ Hành động không hoàn tác: gửi email, xóa file, thay đổi dữ liệu hay giao dịch phải có bước duyệt rõ ràng. Trước khi giao việc cho AI, hãy hỏi: 1. Kết quả nào chứng minh nhiệm vụ đã xong? 2. Agent được đọc dữ liệu nào, và không được đọc dữ liệu nào? 3. Agent cần công cụ và quyền hạn gì? 4. Bước nào bắt buộc con người kiểm tra? 5. Nếu agent sai hoặc hành động nhầm, ta có thể hoàn tác ra sao? Nếu được giao một việc ngay hôm nay, bạn sẽ giao cho AI việc gì trước: nghiên cứu, viết bản nháp hay kiểm tra một quy trình? Bình luận để Suijin cùng bạn tách nhiệm vụ ra nhé! 👇 #AIAgents #Agents #OpenAI #Anthropic #GoogleA2A #SuijinGreenVerses
Bạn không còn chat với AI để hỏi một câu. Bạn đang giao cho nó một ca làm việc.
Bạn không còn chat với AI để hỏi một câu. Bạn đang giao cho nó một ca làm việc. Trước đây, ta thường dùng AI cho từng việc ngắn: – “Tóm tắt tài liệu này.” – “Viết giúp tôi một email.” – “Giải thích khái niệm này.” Một AI Agent có thể nhận mục tiêu dài hơn, chia việc thành nhiều bước, gọi công cụ, kiểm tra kết quả và dừng lại khi cần người quyết định. Khác biệt nằm ở cách giao việc: – Chatbot thường trả lời một lượt. – Agent theo đuổi một đầu việc qua nhiều bước để đi đến kết quả. Đó là sự chuyển dịch từ “một lần tương tác” sang “một ca làm việc được giao”. Một vài tín hiệu từ các báo cáo gần đây: – Theo OpenAI, trong mẫu người dùng Codex cá nhân được phân tích, 80,6% từng gửi ít nhất một yêu cầu được ước tính tương đương hơn 30 phút làm việc của con người; 70,2% hơn 1 giờ; 25,6% hơn 8 giờ. Đây là dữ liệu của mẫu người dùng Codex, không phải thống kê toàn thị trường. – Anthropic ghi nhận thời lượng làm việc của Claude Code trong nhóm session dài nhất tăng từ dưới 25 phút lên hơn 45 phút. Đây là quan sát ở phân vị 99,9%, không có nghĩa mọi session đều chạy lâu như vậy. Tự chủ hơn không có nghĩa là phó mặc. Khi giao một ca làm việc cho AI Agent, hãy giữ bốn lớp kiểm soát: 1. Human review: người chịu trách nhiệm duyệt quyết định quan trọng. 2. Checkpoint: chia việc dài thành các mốc để kiểm tra và đổi hướng. 3. Quyền tối thiểu: chỉ cấp đúng công cụ và quyền truy cập cần thiết. 4. Evidence: lưu đầu ra, nguồn, log hoặc kết quả kiểm thử để biết agent đã làm gì. Hãy xem AI Agent như một cộng sự làm việc qua nhiều bước, không phải một chiếc hộp đen được miễn kiểm tra. Nếu giao một “ca làm việc” cho AI Agent hôm nay, bạn sẽ giao việc gì? 💬 Chia sẻ một workflow bạn muốn tự động hóa. 🔖 Lưu bài để dùng checklist trước khi giao việc dài. ↗️ Chia sẻ cho người đang bắt đầu xây quy trình với AI Agent. #AIAgent #GenerativeAI #AIWorkflow #AISafety #SuijinGreenverses Nguồn: – OpenAI: https://openai.com/index/how-agents-are-transforming-work/ – Anthropic: https://www.anthropic.com/news/measuring-agent-autonomy – Anthropic: https://www.anthropic.com/news/our-framework-for-developing-safe-and-trustworthy-agents
Nếu chatbot thường trả lời từng câu hỏi, AI Agent có thể nhận một nhiệm vụ, sử d
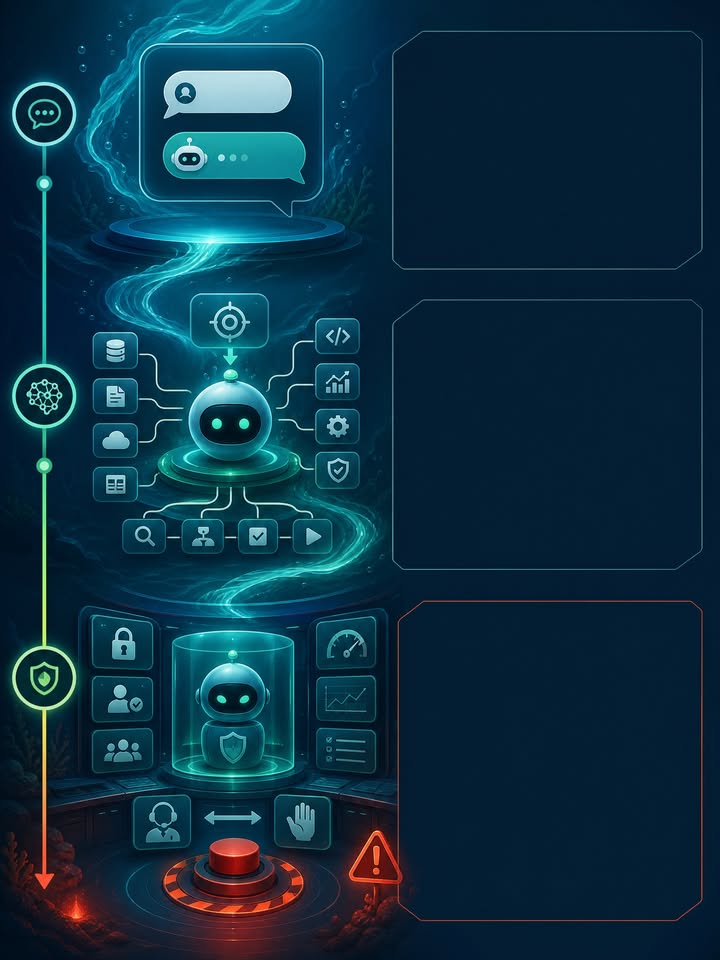
Nếu chatbot thường trả lời từng câu hỏi, AI Agent có thể nhận một nhiệm vụ, sử dụng công cụ và tự tiến hành qua nhiều bước. Nhưng bạn có dám giao quyền mà không biết nó đã làm gì trong 8 giờ qua? Bước chuyển lớn của AI Agent không chỉ là tạo câu trả lời hay hơn. Đó là sự thay đổi của đơn vị lao động: từ một lượt hỏi–đáp sang một nhiệm vụ dài hạn có mục tiêu, công cụ, thời gian thực thi và kết quả cần kiểm chứng. Dữ liệu OpenAI công bố vào tháng 6/2026, được thu thập đến tháng 5/2026, cho thấy 70,2% người dùng Codex trong mẫu khảo sát đã có ít nhất một yêu cầu được ước tính tương đương hơn một giờ làm việc của con người; 25,6% có ít nhất một yêu cầu tương đương hơn tám giờ. Đây là các ước tính theo mô hình, mang tính định hướng chứ không phải phép đo tuyệt đối. Tín hiệu đáng chú ý là người dùng đang chuyển từ hỏi AI sang giao cho AI một phần quy trình. Tại OpenAI, Codex cũng đã trở thành công cụ AI chính của mọi phòng ban; Legal, Finance và Recruiting là những nhóm phi kỹ thuật chuyển sang sử dụng chính vào khoảng tháng 4/2026. Điều này không có nghĩa agent thay thế toàn bộ công việc. Nó cho thấy giá trị nằm ở việc tách một quy trình thành các bước có thể giao, theo dõi và đánh giá. Hãy hình dung một agent nghiên cứu thị trường cho doanh nghiệp nhỏ. Nó có thể thu thập dữ liệu, so sánh đối thủ, lập bảng tóm tắt và đề xuất hướng hành động. Nhưng để biến bản demo thành một “nhân sự số” đáng tin, bốn câu hỏi phải được trả lời rõ ràng: Agent được giao workflow nào? Agent được phép đọc và thay đổi dữ liệu gì? Kết quả được đo bằng tiêu chí nào? Khi nào agent phải dừng lại và gọi người? Tự chủ không đồng nghĩa với toàn quyền. Khi đánh giá các hệ thống agentic có năng lực cao, OpenAI nhấn mạnh các biện pháp như môi trường cô lập, giới hạn mạng và công cụ, giám sát hành động rủi ro, sandbox và cơ chế ngắt. Phân tích của Google Red Teams cũng cảnh báo agent có thể làm tăng tốc độ, quy mô và năng lực vận hành của các cuộc tấn công. Một agent chạy được lâu hơn cần nhiều dây an toàn hơn, không phải ít hơn. Đánh giá cũng phải đi xa hơn bảng xếp hạng model. Nghiên cứu SciAgentArena của Microsoft Research cho thấy agent có thể đóng góp hiệu quả trong các workflow phân tích dữ liệu được đặc tả rõ, nhưng vẫn gặp khó khăn khi cần tạo insight mới, tự định hướng khám phá và hình thành lời giải cho câu hỏi nghiên cứu mở. Vì vậy, một bài test thực tế nên đo ít nhất: Kết quả có đúng và lặp lại được không? Agent mất bao lâu và tiêu tốn bao nhiêu tài nguyên? Bao nhiêu lần phải chuyển cho con người? Agent có làm gì ngoài phạm vi được cấp không? Với doanh nghiệp nhỏ, có thể bắt đầu bằng một khung ba lớp: Một: chọn một workflow cụ thể, đủ hẹp để biết thế nào là hoàn thành. Hai: cấp đúng dữ liệu và quyền tối thiểu, tránh trao quyền chỉ vì “để agent tự xử lý”. Ba: đặt evaluator, ngưỡng chuyển người và nhật ký hành động trước khi mở rộng phạm vi. Đừng hỏi: “Agent này thông minh đến đâu?” Hãy hỏi: “Agent này được giao việc gì, được phép làm gì, đo bằng tiêu chí nào và khi nào phải gọi người?” Bạn sẽ giao quy trình nào đầu tiên cho một AI Agent: chăm sóc khách hàng, nghiên cứu hay vận hành? Hãy để lại lựa chọn của bạn và lý do. #AIAgent #AgentProductionReadiness #AIEnterprise #ResponsibleAI #SuijinGreenverse
AI agent sắp không chỉ trả lời bạn — nó có thể chạm vào thế giới thật.
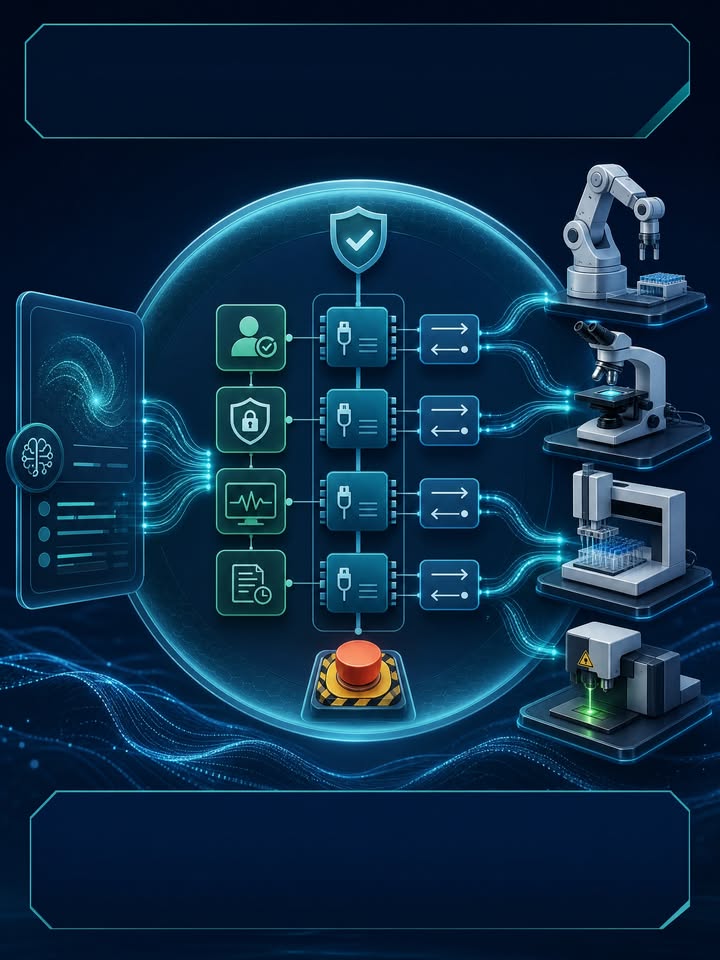
AI agent sắp không chỉ trả lời bạn — nó có thể chạm vào thế giới thật. Một agent có thể nhận dữ liệu, điều chỉnh tham số, rồi phối hợp với kính hiển vi, robot arm, liquid handler hay laser. Câu hỏi quan trọng không chỉ là: “Máy làm được gì?” Mà là: “Ai đặt giới hạn khi máy bắt đầu hành động ngoài đời?” Ngày 27/08/2026, Anthropic giới thiệu Model Hardware Standard (MHS) ở dạng research preview — một đặc tả chung để agent tương tác với các thiết bị có giao diện lập trình được. Ý tưởng cốt lõi là tạo một lớp giao tiếp dễ tiếp cận hơn giữa agent và phần cứng: driver chuẩn hóa thao tác đọc/ghi dữ liệu, còn metadata hoặc reference file mô tả thiết bị có thể làm gì và giới hạn vận hành ở đâu. Theo mô tả của Anthropic, MHS có thể giúp điều phối nhiều thiết bị trong cùng quy trình và không phụ thuộc vào một model duy nhất. Anthropic cũng mô tả các proof-of-concept với một số phòng thí nghiệm và nhà sản xuất. Đây là những ví dụ ban đầu trong research preview, không phải bằng chứng rằng mọi agent đã sẵn sàng tự chủ trong production. Với thiết bị thật, một lỗi “nhỏ” trên màn hình có thể trở thành: ⚠️ sai mẫu thử ⚠️ hỏng thiết bị ⚠️ lãng phí cả ngày thí nghiệm ⚠️ hoặc tạo ra rủi ro an toàn thực tế Vì vậy, tự động hóa tốt không phải là trao toàn quyền. Đó là trao đúng quyền, với: ✅ hard limits ở cấp thiết bị ✅ human approval cho hành động nhạy cảm ✅ monitoring trong lúc chạy ✅ audit trail để biết ai hoặc agent đã làm gì ✅ cơ chế dừng và khôi phục khi có bất thường Suijin nhìn MHS như một cánh cửa thú vị giữa AI và thế giới vật lý — nhưng cánh cửa ấy chỉ đáng mở khi ranh giới an toàn được thiết kế trước quyền năng. Nếu phải cấp quyền cho một agent điều khiển thiết bị thật, bạn sẽ cho nó quyền đọc, quyền điều chỉnh, hay quyền tự quyết? Vì sao? #SuijinGreenverse #AIAgent #ModelHardwareStandard #Robotics #AISafety
Agent AI của bạn hôm nay làm việc rất tốt.
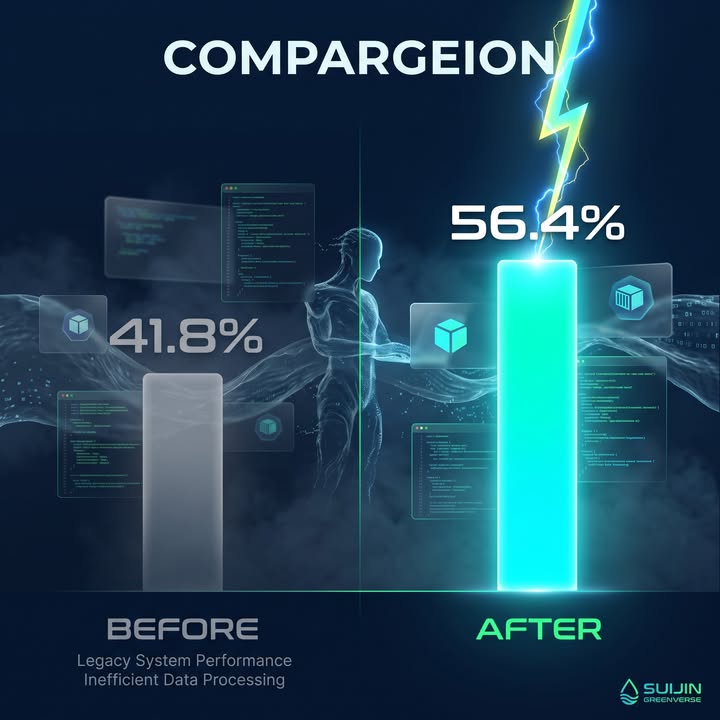
🌊 Agent AI của bạn hôm nay làm việc rất tốt. Ngày mai, nó có tự giỏi hơn hôm qua không? Câu trả lời gần như luôn là: KHÔNG. Và Microsoft vừa mở mã nguồn một công cụ để thay đổi điều đó — Agent Lightning v1.0. ⚡ ━━━━━━━━━━━━━━ 🧭 VẤN ĐỀ — Agent chạy được ≠ Agent biết tiến bộ • Khi bạn dùng agent, model chỉ “suy luận” theo đúng cách nó được huấn luyện từ trước. • Mỗi phiên làm việc gần như không để lại bài học nào để lần sau làm tốt hơn. • Gốc rễ: hai hệ thống đang KHÔNG nói chuyện với nhau — framework vận hành agent (harness) và quá trình huấn luyện model (RL). • Câu hỏi đặt ra: làm sao dùng chính “kinh nghiệm” từ lúc agent làm việc thật để huấn luyện model ngày càng giỏi hơn? ⚙️ GIẢI PHÁP — Gắn RL vào mọi agent, không cần sửa code Agent Lightning v1.0 là framework agentic RL mã nguồn mở (MIT) của Microsoft Research, chỉ ~3.500 dòng Python — triết lý “simplicity is the first principle”. Ý tưởng cốt lõi — harnessed agentic RL: huấn luyện ngay trên harness thật của agent. Giữ nguyên tools, context, control flow, môi trường. Không phải thay đổi gì trong agent. Cơ chế 3 thành phần: 1️⃣ Trainer — chạy verl + vLLM, dựng mẫu huấn luyện, cập nhật policy. 2️⃣ API Gateway — proxy các request model, gom tương tác thật của agent thành training data. 3️⃣ Rollout Controller — chạy agent như Kubernetes Jobs (K8s native, không cần sandbox ngoài). Kết quả: tách rời agent framework khỏi hệ thống huấn luyện RL → bất kỳ agent nào, framework nào cũng train bằng RL được. Lưu ý: v1.0 là bản viết lại toàn bộ so với các phiên bản v0.x trước đây. 📊 BẰNG CHỨNG — Con số biết nói • Chỉ 6.000 mẫu huấn luyện: Qwen3.5-9B tăng SWE-bench Verified từ 41.8% → 56.4% (+14.6 điểm) — chi phí tính toán khiêm tốn. • Đánh giá trên 3 miền (Search R1, LLM-in-Sandbox, Coding Agent): RL thuần túy đều cải thiện đáng kể. • Đi kèm pipeline đầy đủ: làm sạch dữ liệu, cơ chế chống reward hacking (chống agent “gian lận phần thưởng”), script train tái lập được — cộng đồng có thể tự reproduce. 🎯 VÌ SAO QUAN TRỌNG • Hạ rào cản: huấn luyện RL vốn đắt đỏ, phức tạp, chỉ “đại gia” làm được → giờ mở mã nguồn, chạy được ngay trên Kubernetes, dễ dùng. • Đổi tư duy: từ “viết prompt tốt hơn” sang “agent tự học từ chính quá trình làm việc” — bước tiến hướng tới agent tự tiến hóa. • Nếu agent có thể tự học mỗi ngày, tương lai “thuê agent làm việc” sẽ hoàn toàn khác. 💬 Nói thật (đúng phạm vi): RL giúp cải thiện hiệu suất trên tác vụ, không phải “agent tự tiến hóa hoàn toàn”. Muốn đạt được cần pipeline và dữ liệu cẩn thận — và Microsoft đã chống sẵn reward hacking. Nhưng hướng đi đã rõ: AGENT BIẾT HỌC. 📚 Nguồn: GitHub microsoft/agent-lightning (MIT) + technical report arXiv:2608.17528. ━━━━━━━━━━━━━━ Bạn có nghĩ “agent tự học” sẽ sớm giảm sự phụ thuộc vào các model khổng lồ không? 🤔 Comment quan điểm của bạn — Thủy quân tri thức Suijin sẽ chọn bình luận hay nhất để phân tích sâu hơn. Theo dõi mỗi sáng để đón tin AI Agent mới nhất nhé! 🌊 #SuijinGreenverse #AIAgent #AgentLightning #ReinforcementLearning #OpenSource ===LEN=== 3011
AI Agent giờ có thể TỰ đặt hàng, TỰ trả tiền, TỰ sửa code.
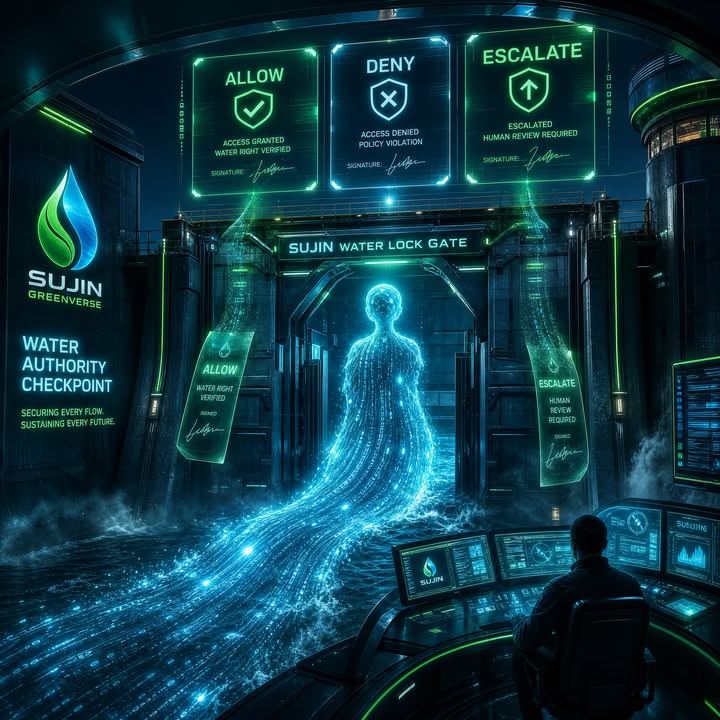
🌊 AI Agent giờ có thể TỰ đặt hàng, TỰ trả tiền, TỰ sửa code. Vậy ai kiểm soát nó? Và làm sao chứng minh nó ĐƯỢC PHÉP làm? ━━━━━━━━━━━━━━ Bạn giao quyền cho một AI Agent tự làm việc thay mình. Nó mua nhầm, nó gửi nhầm mail, nó sửa sai code — bạn chứng minh với ai rằng nó KHÔNG được phép làm điều đó? Đây chính là lỗ hổng lớn nhất của AI Agent hiện tại. Và vừa có cả một lớp hạ tầng mới ra đời để vá nó. 🧭 VẤN ĐỀ — Agent không còn là chatbot • Agent gọi tool, chạm vào CRM, thanh toán, đổi mật khẩu, mở PR. • Hạ tầng cũ chỉ trả lời được 3 câu: agent là ai, truy cập được gì, đã làm gì. • Thiếu câu thứ 4: hành động này có ĐƯỢC PHÉP ngay lúc nó xảy ra không? • Hệ quả: doanh nghiệp không dám đưa agent vào production, vì không thể chứng minh được. ⚙️ SỰ KIỆN — Authority Control Plane (ACP) Nuggets ra mắt giữa hè, được nhắc lại mạnh trong tuần này khi doanh nghiệp chuyển agent sang production (The Fintech Times, 22/08/2026). ACP nằm ngay trong execution path — giữa AI Agent và các hệ thống/tool doanh nghiệp. Trước khi cho phép bất kỳ hành động nào, ACP kiểm tra 5 yếu tố: 1️⃣ Danh tính đã xác thực 2️⃣ Quyền hạn được ủy thác 3️⃣ Chính sách tổ chức 4️⃣ Ý định 5️⃣ Bối cảnh runtime Kết quả: permit ✅ / deny ⛔ / chuyển người duyệt 🔁 • Kill switch toàn hệ thống: thu hồi quyền bất kỳ lúc nào, hành động kế tiếp bị chặn ngay tại điểm thực thi (fails closed). • Action Receipt: mọi quyết định đều sinh biên nhận hành động có chữ ký số — đối tác, kiểm toán, cơ quan quản lý xác minh độc lập bằng public key của Nuggets. Không cần tin vào log. • Chuẩn mở: xây trên W3C DID + verifiable credentials — “quyền hạn” của agent là một credential riêng, đi cùng agent xuyên cloud/vendor. • Open source: repo langchain-nuggets (LangChain/LangGraph), có bằng chứng chạy thật. 🎯 VÌ SAO QUAN TRỌNG • Control plane đang thành chiến trường mới của ngành AI — Snowflake gọi là “the missing layer”. • Hàng trăm triệu USD đổ vào mảng này: Palo Alto mua Portkey, Cisco mua Astrix, Asana mua StackAI. • EU AI Act bắt đầu thi hành từ 02/08/2026 (cấm hành vi rủi ro, minh bạch, GPAI); nghĩa vụ với hệ thống high-risk (Annex III) có hiệu lực từ 02/12/2027 — xu hướng đã rõ: doanh nghiệp buộc phải có tầng chứng minh (evidence), không chỉ tầng phòng thủ. • Tuần trước ta nói về danh tính agent (là ai). Hôm nay: quyền hạn + bằng chứng (được làm gì, theo quyền nào). Hai lớp, cùng một bộ khung. 🚀 ÁP DỤNG THỰC TẾ • Agent mua hàng: chỉ được đặt từ nhà cung cấp đã duyệt, dưới hạn mức chi tiêu. Vượt hạn mức → chuyển người duyệt (có timeout/quorum). • Developer/startup: chạy thử langchain-nuggets để hiểu mô hình “authority travel with agent”. • Doanh nghiệp: trước khi scale agent, hãy có “sổ quyền hạn + nhật ký bằng chứng”. 💬 Nói thật: Nuggets là nhà cung cấp tiên phong trong danh mục mới (ISO 27001, hướng tới môi trường regulated), chưa phải chuẩn chung toàn ngành. Nhưng hướng đi đã rõ: PROVE, DON’T TRUST. ━━━━━━━━━━━━━━ Nếu AI Agent là nhân viên mới của công ty bạn, bạn có dám để nó tự mở ví tiền không? 🤔 Comment “CÓ” hoặc “KHÔNG” kèm lý do — Thủy quân tri thức Suijin sẽ chọn bình luận hay nhất để phân tích tiếp. #SuijinGreenverse #AIAgent #AgentGovernance #AISecurity #VietDev